https://berangkatinumrah.id/faqs.
Prasyarat
URL website target dapat diakses secara publik tanpa captcha atau proteksi login ketat.
Akun Anda memiliki akses ke instance WhatsApp di portal DripSender.
1. Memilih Web Extractor pada Menu Alat (Step 1)
- Buka menu Agent AI di portal DripSender, lalu klik tab Tools.
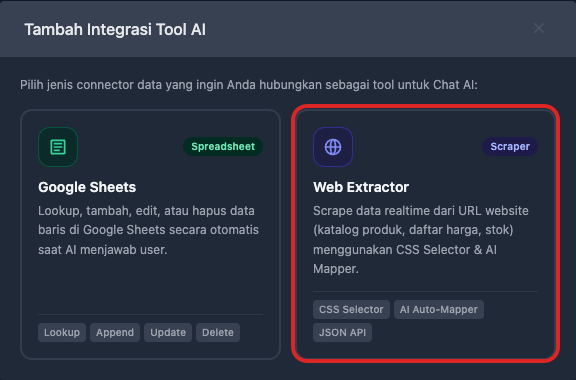
- Pada kartu bagian bawah Integrasi, klik tombol Tambah Integrasi.
- Di modal pemilihan jenis connector data, pilih kartu Scraper - Web Extractor yang ditandai kotak merah:
2. Mengisi Nama Integrasi dan Deskripsi Pemicu untuk AI (Step 2)
Modal konfigurasi Web Extractor akan terbuka pada langkah 1 Setup URL & Parameters: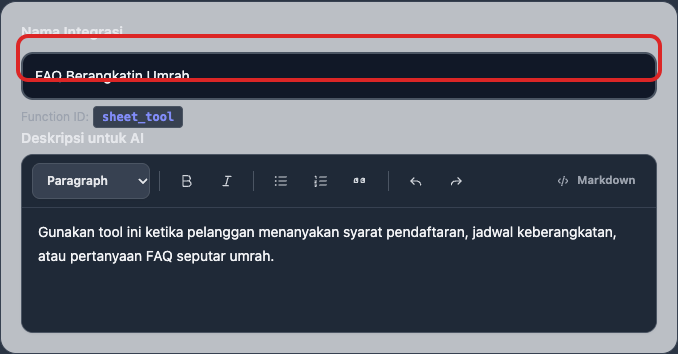
- Nama Integrasi:
Beri nama integrasi yang mudah dikenali, misalnya:
FAQ Berangkatin Umrah. - Deskripsi untuk AI:
Jelaskan instruksi kapan AI harus memanggil tool ini:
Contoh:
“Gunakan tool ini ketika pelanggan menanyakan syarat pendaftaran, jadwal keberangkatan, rincian biaya paket, visa, atau pertanyaan FAQ seputar umrah.”
3. Mendaftarkan Domain yang Diizinkan (Allowed Hosts) (Step 3)
Demi alasan keamanan jaringan dan mencegah bot mengakses domain berbahaya, daftarkan domain website resmi Anda pada kolom Allowed Hosts: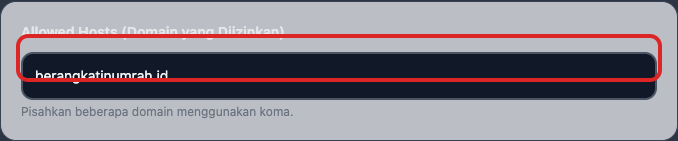
https:// (pisahkan dengan koma jika ada lebih dari satu domain):
4. Menentukan Mode URL dan URL Template Target (Step 4)
Pada bagian Mode URL Website dan URL Template Target: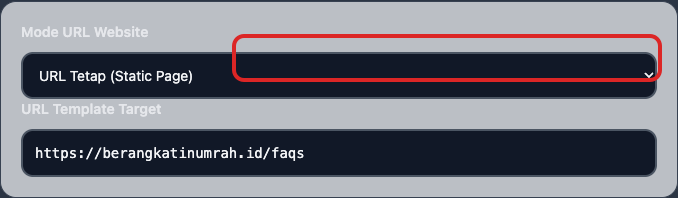
- Mode URL Website:
Pilih URL Tetap (Static Page) karena kita menargetkan satu halaman FAQ permanen.
(Pilih mode dinamis dengan parameter jika Anda ingin bot mengakses URL produk berdasarkan slug tertentu, misal
https://tokosaya.com/produk/{{slug}}). - URL Template Target:
Masukkan URL lengkap halaman FAQ tujuan:
5. Mengatur Batas Waktu dan Durasi Cache (Step 5)
Pada bagian Timeout (ms) dan Cache TTL (detik):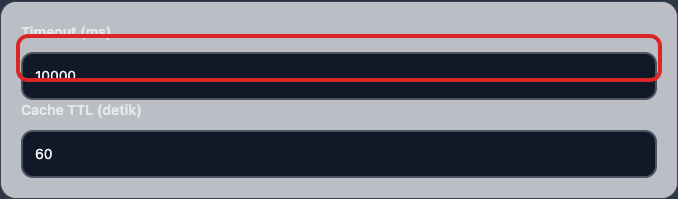
- Timeout (ms): Masukkan angka
10000(10 detik waktu tunggu maksimal pemuatan halaman). - Cache TTL (detik): Masukkan angka
60detik (menyimpan hasil pembacaan web dalam cache sementara agar bot tidak memuat ulang halaman secara berulang-ulang untuk chat yang masuk bersamaan). - Klik tombol biru Lanjut ke JSON Mapper →.
6. Menyiapkan JSON Mapper & AI Scrape (Step 6)
Pada langkah kedua 2 JSON Mapper & AI Scrape, tentukan bagaimana konten halaman web diekstraksi ke dalam format terstruktur yang dipahami model AI: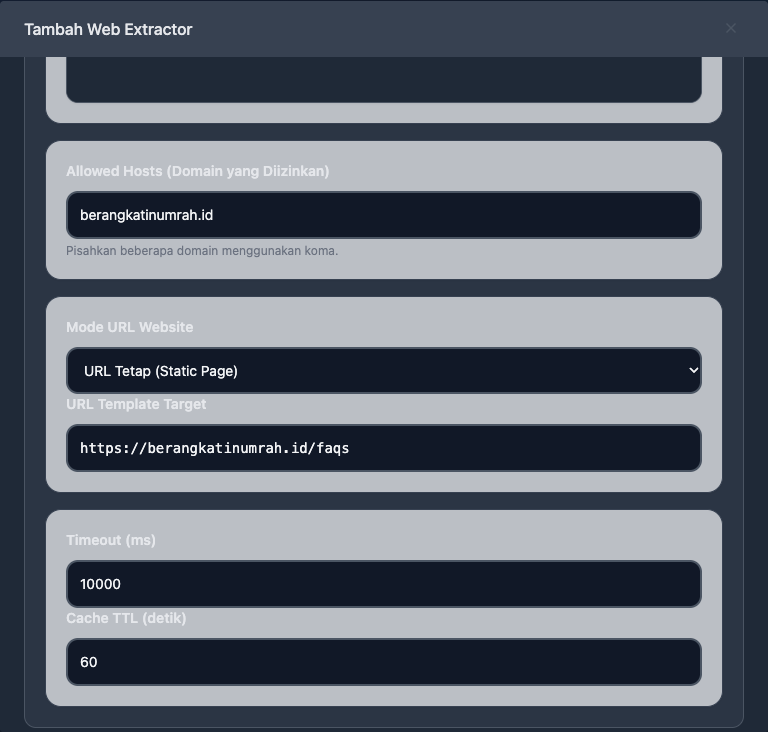
- Mode AI Auto-Mapper: Secara default, AI akan memindai kontainer teks halaman web secara otomatis untuk mengekstrak pasangan pertanyaan dan jawaban FAQ yang relevan.
- CSS Selector Kustom (Opsional):
Jika Anda hanya ingin mengekstrak blok elemen tertentu dari website, tentukan selector HTML spesifik (misalnya
.faq-list,article.content, atau.accordion-body). - Klik tombol biru Tambah Integrasi atau Simpan Integrasi.
7. Pengujian Respon Agent AI
Setelah integrasi tersimpan:- Buka tab Uji Coba (Playground).
- Kirim pesan pengujian sebagai calon jamaah (misalnya: “Berapa lama proses pembuatan visa umrah?” atau “Apakah ada syarat vaksin untuk lansia?”).
- Agent AI akan secara otomatis memanggil Web Extractor, membaca data realtime dari
https://berangkatinumrah.id/faqs, dan menyusun jawaban yang akurat sesuai informasi di situs web tersebut.